完成H20服务器部署及重启测试 (#51)
当前部署情况 - h1: 部署server & client - h2: 部署client - 部署2025-11-25 - 部署目录: /home2/argus/server , /home2/argus/client - 部署使用账号:argus 网络拓扑: - h1 作为docker swarm manager - h2 作为worker加入docker swarm - docker swarm 上创建overlay network 访问方式: - 通过ssh到h1服务器,端口转发 20006-20011 端口到笔记本本地; - 门户网址:http://localhost:20006/dashboard 部署截图: 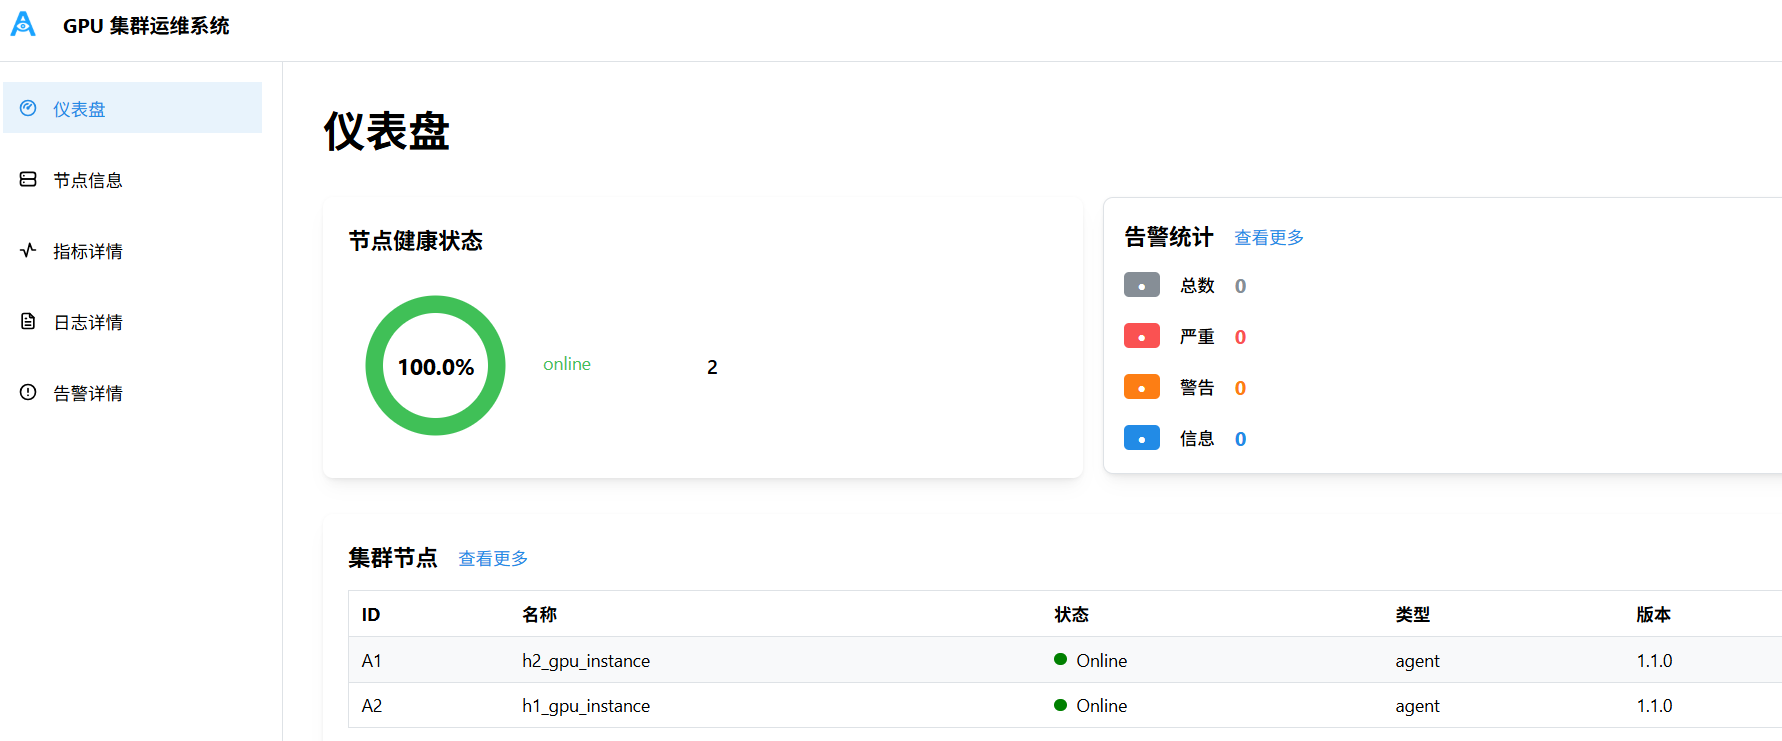 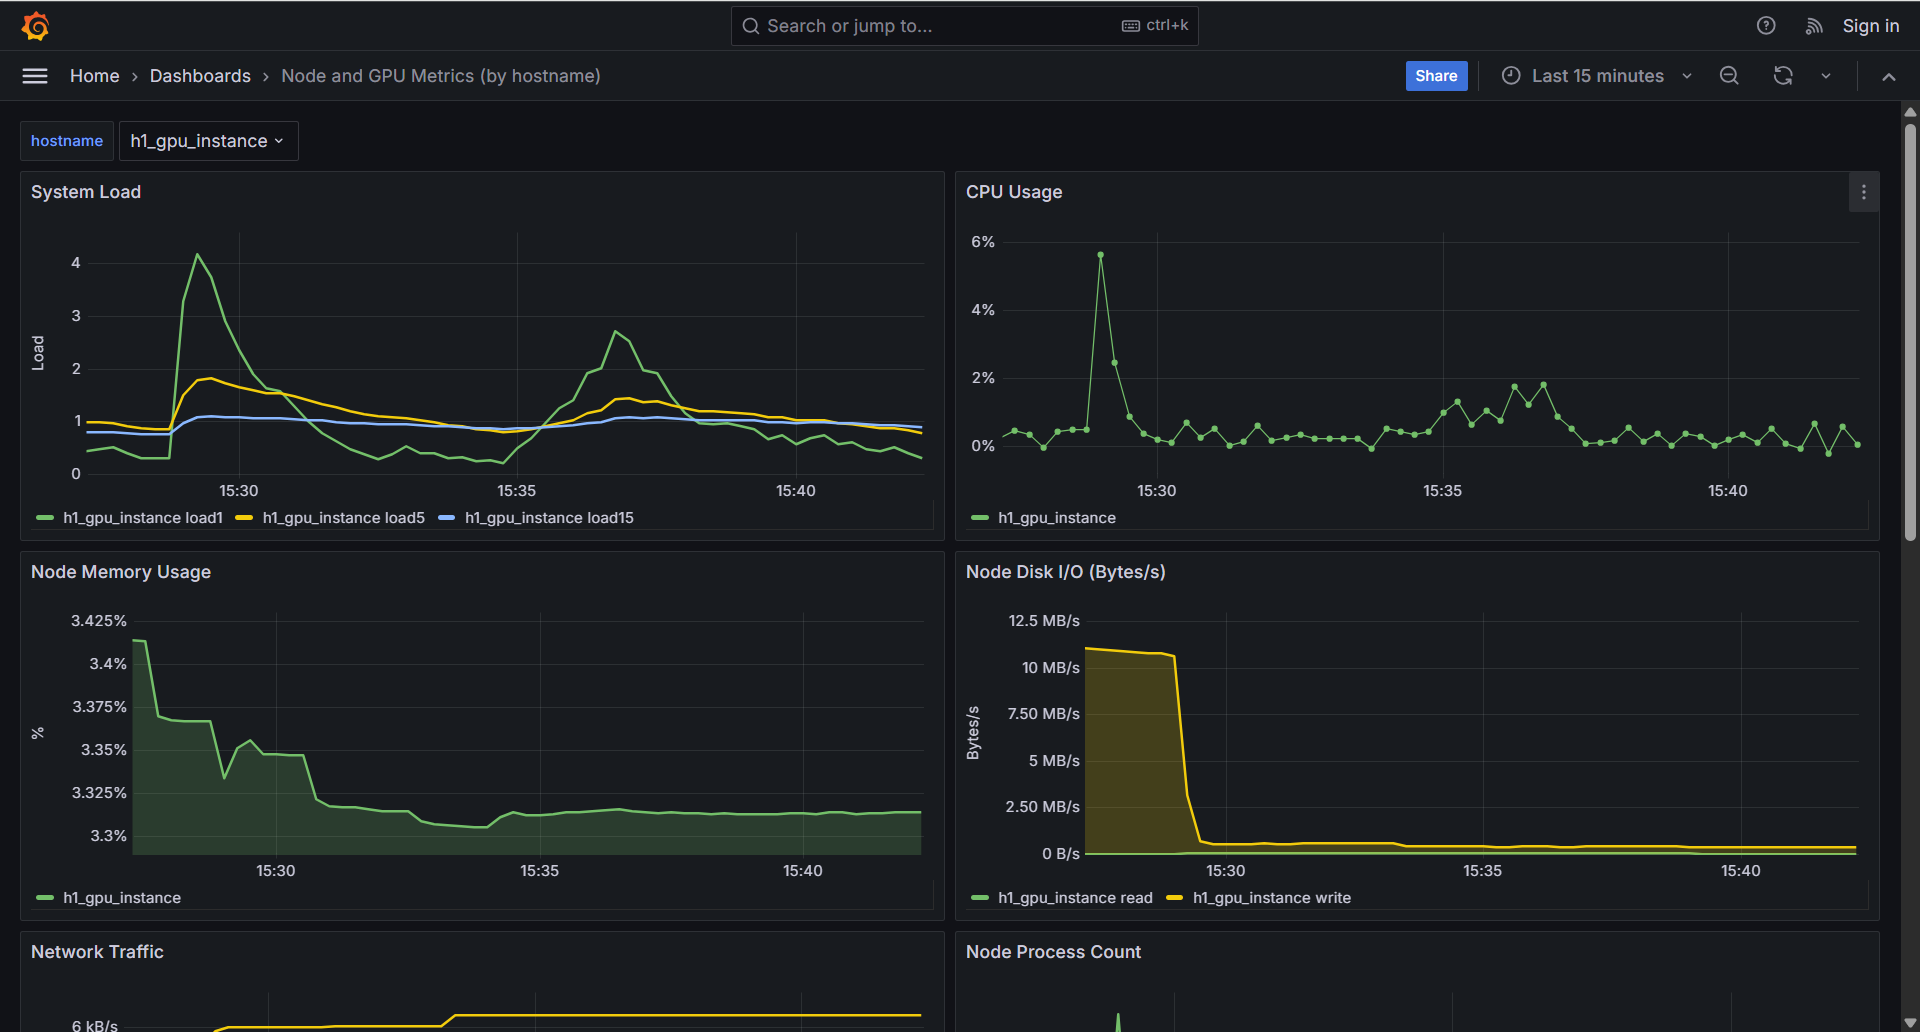 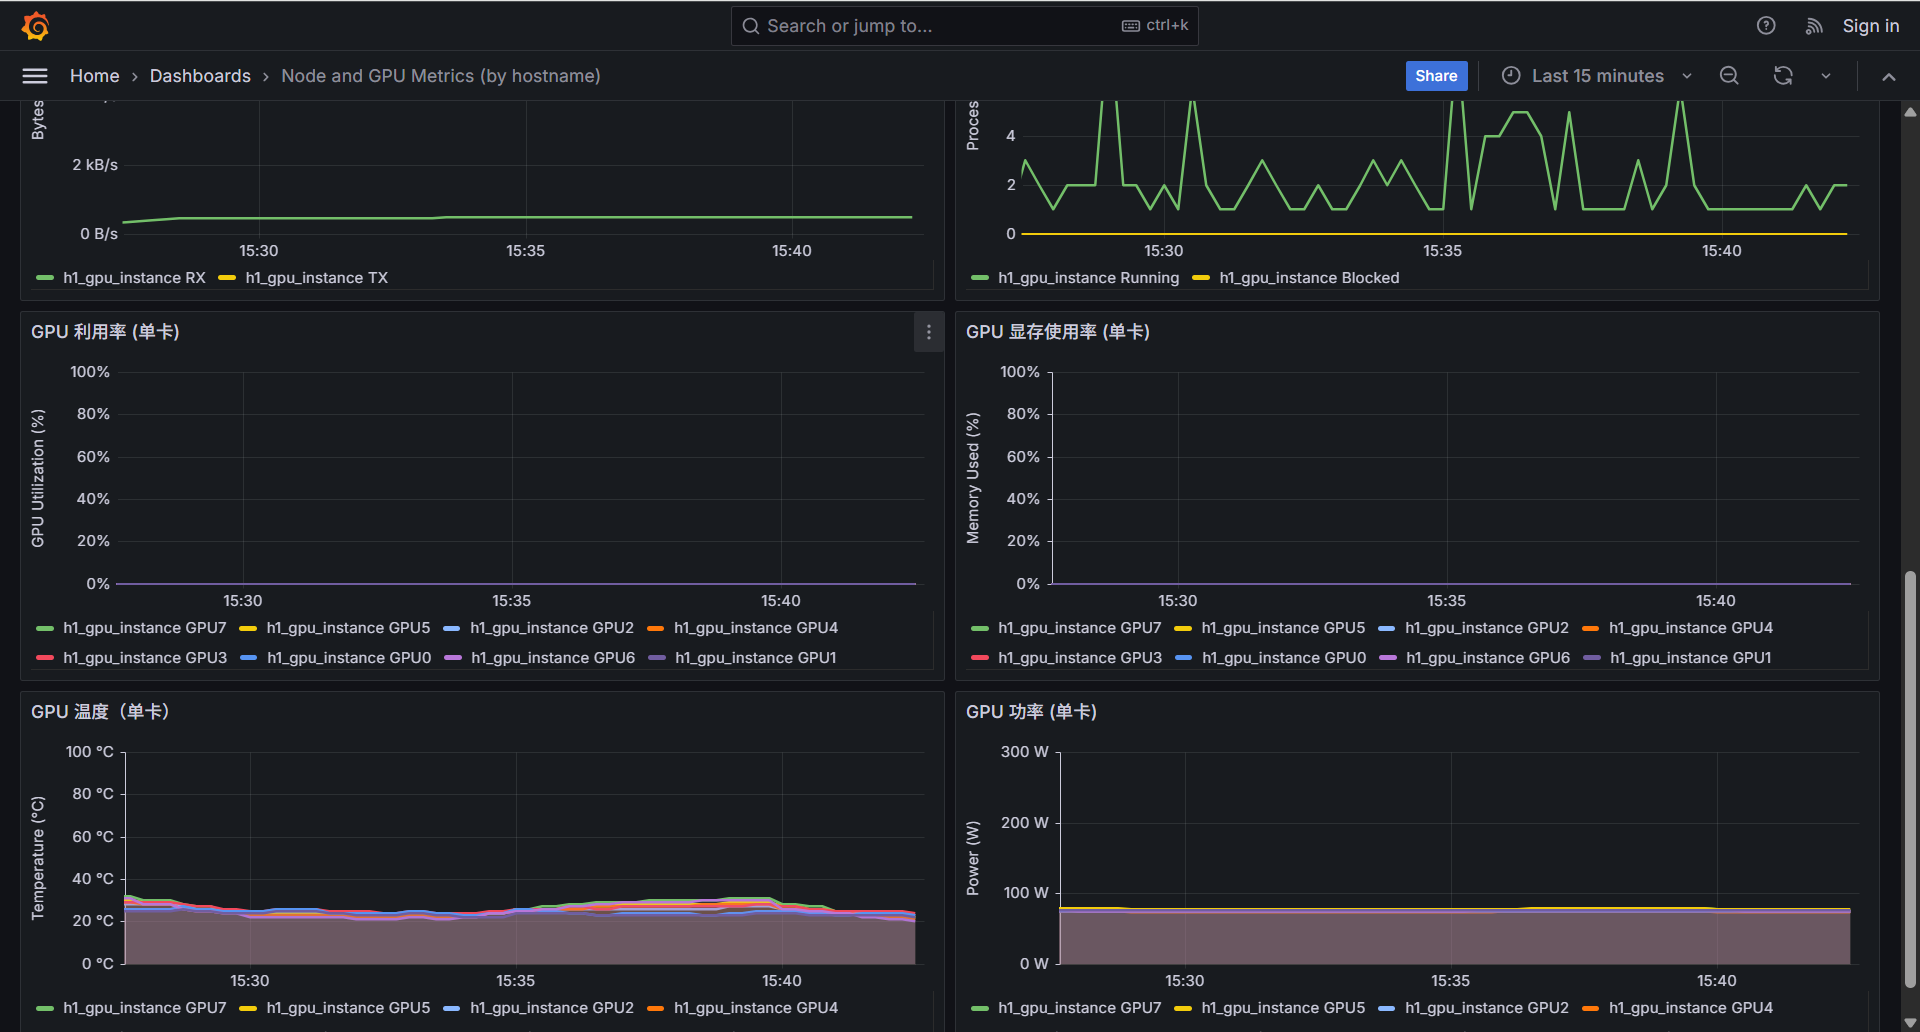 注意事项: - server各容器使用域名作为overlay network上alias别名,实现域名访问,当前版本禁用bind作为域名解析,原因是容器重启后IP变化场景bind机制复杂且不稳定。 - client 构建是内置安装包,容器启动时执行安装流程,后续重启容器跳过安装步骤。 - UID/GID:部署使用 argus账号 uid=2133, gid=2015。 Reviewed-on: #51 Reviewed-by: sundapeng <sundp@mail.zgclab.edu.cn> Reviewed-by: xuxt <xuxt@zgclab.edu.cn> Reviewed-by: huhy <husteryezi@163.com>
This commit was merged in pull request #51.
This commit is contained in:

@@ -0,0 +1,73 @@
|
||||
# Argus Client‑GPU 安装指南(deployment_new)
|
||||
|
||||
## 一、准备条件(开始前确认)
|
||||
- GPU 节点安装了 NVIDIA 驱动,`nvidia-smi` 正常;
|
||||
- Docker & Docker Compose v2 已安装;
|
||||
- 使用统一账户 `argus`(UID=2133,GID=2015)执行安装,并加入 `docker` 组(如已创建可跳过):
|
||||
```bash
|
||||
sudo groupadd --gid 2015 argus || true
|
||||
sudo useradd --uid 2133 --gid 2015 --create-home --shell /bin/bash argus || true
|
||||
sudo passwd argus
|
||||
sudo usermod -aG docker argus
|
||||
su - argus -c 'id; docker ps >/dev/null && echo OK || echo NO_DOCKER_PERMISSION'
|
||||
```
|
||||
后续解压与执行(config/install/uninstall)均使用 `argus` 账户进行。
|
||||
- 从 Server 安装方拿到 `cluster-info.env`(包含 `SWARM_MANAGER_ADDR/SWARM_JOIN_TOKEN_*`;compose 架构下 BINDIP/FTPIP 不再使用)。
|
||||
|
||||
## 二、解包
|
||||
- `tar -xzf client_gpu_YYYYMMDD.tar.gz`
|
||||
- 进入目录:`cd client_gpu_YYYYMMDD/`
|
||||
- 你应当看到:`images/`(GPU bundle、busybox)、`compose/`、`scripts/`、`docs/`。
|
||||
|
||||
## 三、配置 config(预热 overlay + 生成 .env)
|
||||
命令:
|
||||
```
|
||||
cp /path/to/cluster-info.env ./ # 或 export CLUSTER_INFO=/abs/path/cluster-info.env
|
||||
./scripts/config.sh
|
||||
```
|
||||
脚本做了什么:
|
||||
- 读取 `cluster-info.env` 并 `docker swarm join`(幂等);
|
||||
- 自动用 busybox 预热 external overlay `argus-sys-net`,等待最多 60s 直到本机可见;
|
||||
- 生成/更新 `compose/.env`:填入 `SWARM_*`,并“保留你已填写的 AGENT_* 与 GPU_NODE_HOSTNAME”(不会覆盖)。
|
||||
|
||||
看到什么才算成功:
|
||||
- 终端输出类似:`已预热 overlay=argus-sys-net 并生成 compose/.env;可执行 scripts/install.sh`;
|
||||
- `compose/.env` 至少包含:
|
||||
- `AGENT_ENV/AGENT_USER/AGENT_INSTANCE/GPU_NODE_HOSTNAME`(需要你提前填写);
|
||||
- `SWARM_MANAGER_ADDR/SWARM_JOIN_TOKEN_*`;
|
||||
- `NODE_GPU_BUNDLE_IMAGE_TAG=...:YYYYMMDD`。
|
||||
|
||||
### 日志映射(重要)
|
||||
- 容器内 `/logs/infer` 与 `/logs/train` 已映射到包根 `./logs/infer` 与 `./logs/train`:
|
||||
- 你可以直接在宿主机查看推理/训练日志:`tail -f logs/infer/*.log`、`tail -f logs/train/*.log`;
|
||||
- install 脚本会自动创建这两个目录。
|
||||
|
||||
若提示缺少必填项:
|
||||
- 打开 `compose/.env` 按提示补齐 `AGENT_*` 与 `GPU_NODE_HOSTNAME`,再次执行 `./scripts/config.sh`(脚本不会覆盖你已填的值)。
|
||||
|
||||
## 四、安装 install(加载镜像 + 起容器 + 跟日志)
|
||||
命令:
|
||||
```
|
||||
./scripts/install.sh
|
||||
```
|
||||
脚本做了什么:
|
||||
- 如有必要,先自动预热 overlay;
|
||||
- 从 `images/` 导入 `argus-sys-metric-test-node-bundle-gpu-*.tar.gz` 到本地 Docker;
|
||||
- `docker compose up -d` 启动 GPU 节点容器,并自动执行 `docker logs -f argus-metric-gpu-node-swarm` 跟踪安装过程。
|
||||
|
||||
看到什么才算成功:
|
||||
- 日志中出现:`[BOOT] local bundle install OK: version=...` / `dcgm-exporter ... listening` / `node state present: /private/argus/agent/<hostname>/node.json`;
|
||||
- `docker exec argus-metric-gpu-node-swarm nvidia-smi -L` 能列出 GPU;
|
||||
- 在 Server 侧 Prometheus `/api/v1/targets` 中,GPU 节点 9100(node-exporter)与 9400(dcgm-exporter)至少其一 up。
|
||||
|
||||
## 五、卸载 uninstall
|
||||
命令:
|
||||
```
|
||||
./scripts/uninstall.sh
|
||||
```
|
||||
行为:Compose down(如有 .env),并删除 warmup 容器与节点容器。
|
||||
|
||||
## 六、常见问题
|
||||
- `本机未看到 overlay`:config/install 已自动预热;若仍失败,请检查与 manager 的网络连通性以及 manager 上是否已创建 `argus-sys-net`。
|
||||
- `busybox 缺失`:确保包根 `images/busybox.tar` 在,或主机已有 `busybox:latest`。
|
||||
- `加入 Swarm 失败`:确认 `cluster-info.env` 的 `SWARM_MANAGER_ADDR` 与 `SWARM_JOIN_TOKEN_WORKER` 正确,或在 manager 上重新 `docker swarm join-token -q worker` 后更新该文件。
|
||||
Reference in New Issue
Block a user